Как работает языковая модель
Без понимания, как устроена модель, нейросеть кажется волшебством, а её ошибки — сюрпризом. Здесь основа: что такое модель, токены, контекст и почему ей нельзя верить на слово.
Языковая модель — не поисковик и не человек. Она правдоподобно продолжает текст. Отсюда её сильные стороны и главная слабость: галлюцинации.
Что такое языковая модель
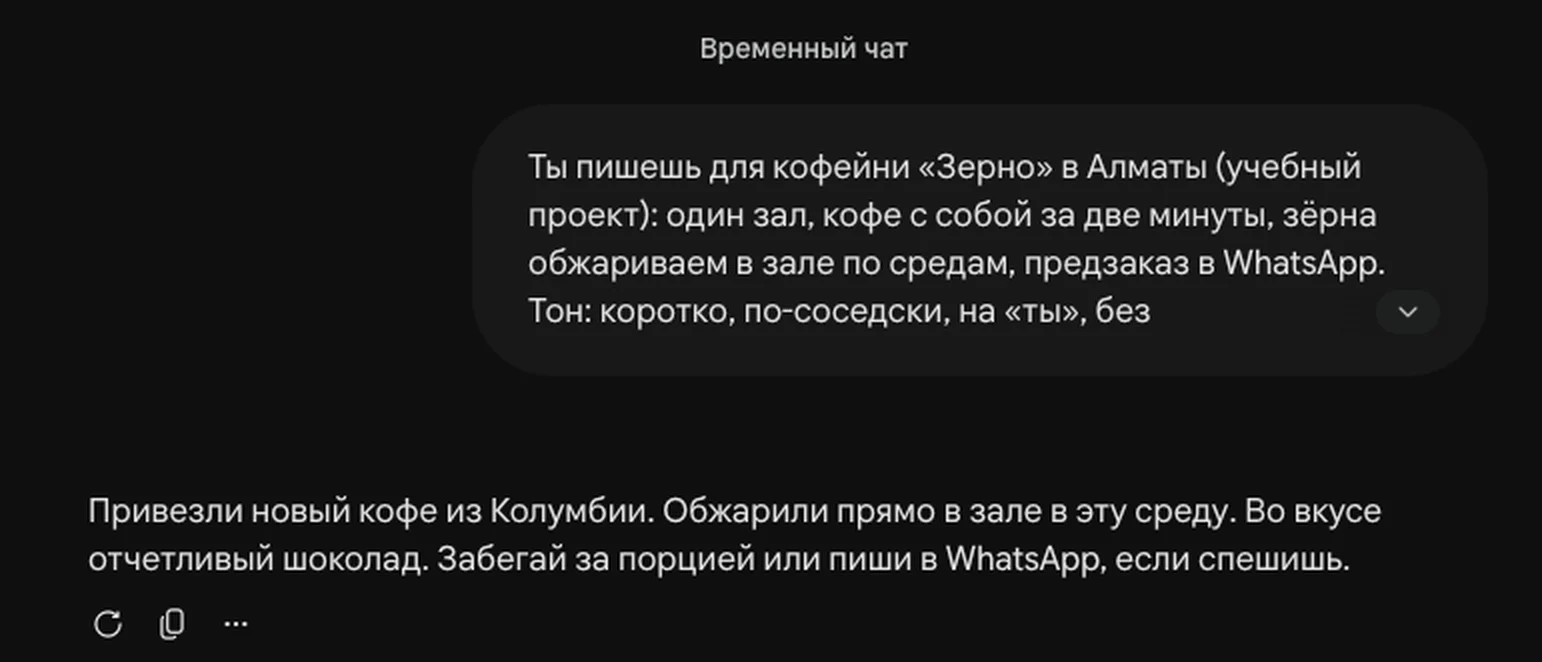
Сквозной пример курса — кофейня «Зерно» в Алматы. Один зал, кофе с собой и зёрна на вынос, Instagram, WhatsApp и небольшой сайт. Кофейня учебная, цифры в примерах выдуманные и круглые, чтобы считалось в уме. Свой проект подставишь на практике.
Программа, обученная на огромном количестве текстов угадывать, какой кусочек текста вероятнее всего идёт дальше. Из таких догадок складываются целые ответы. Она не достаёт ответ из базы и не знает фактов, как человек: она правдоподобно продолжает текст.
ПримерПросишь подпись к фото латте. Модель не берёт готовую подпись с полки, а строит её кусок за куском так, как обычно пишут такие подписи.
Оболочка вокруг модели: окно переписки, история диалога, иногда поиск в интернете и загрузка файлов. Когда говорят «открыл нейросеть», обычно имеют в виду её. Модель и оболочка — разные вещи, и умения зависят от обоих.
ПримерВ одном сервисе ты приложишь таблицу «Зерна» файлом, в другом сможешь только вставить текст. Возможности оболочки разные, даже если внутри похожие модели.
Всё, что ты отправляешь модели: вопрос, задание, образец, вставленный текст. Результат зависит от промпта сильнее, чем от выбора сервиса. Как писать промпты, разберём в следующем уроке.
Пример«Напиши три подписи к фото латте для Instagram кофейни, по одной строке» — это промпт.
Удобная картинка: модель — очень начитанный стажёр. Отвечает быстро и уверенно, но твоего бизнеса не видел и за результат не отвечает. Отвечаешь ты.
Токены
Кусок текста, на которые модель режет всё, что читает и пишет: слово целиком, часть слова, знак препинания. Модель работает токенами, а не буквами и не словами. В токенах считают размер диалога и, в сервисах с оплатой по расходу, стоимость.
ПримерКороткое «кофе» может уложиться в один токен, а «предзаказ» разобьётся на несколько. Разбиение у каждой модели своё, а русский текст обычно занимает больше токенов, чем английский такой же длины.
Практический вывод: модель плохо считает буквы и символы. Просишь «ровно 120 знаков» — получишь около 120. Если лимит жёсткий, как в подписи под рекламным объявлением, считай длину сам.
Контекст
Сколько текста модель удерживает перед глазами за один разговор: твои сообщения, её ответы, вставленные документы. Измеряется в токенах. Что не поместилось, модель не видит. В новом чате она не помнит прошлых, если сервис не хранит память отдельно.
ПримерВ начале чата ты вставил описание «Зерна» и тон бренда. Через сто сообщений ответы стали общими, будто тон забыт: начало потонуло в длинной переписке. Лечение — повторить главное или начать новый чат с короткой вводной.
Отдельная функция некоторых ассистентов: сохранять факты о тебе между чатами. Это не часть модели, она включается и выключается в настройках, а сохранённое можно посмотреть и стереть.
ПримерСервис запомнил: «Зерно» пишет на «ты» и без восклицательных знаков. Проверь, что именно записано, и убери лишнее, особенно данные клиентов.
- Одна задача — один чат. Смешанный диалог про рилс, отзывы и договор путает модель
- В начале — вводная: кто ты, что за бизнес, какой тон
- Длинный диалог поплыл — попроси «собери итог договорённостей в десять строк», открой новый чат и вставь итог
- Важное повторяй, а не надейся, что модель помнит
Галлюцинации
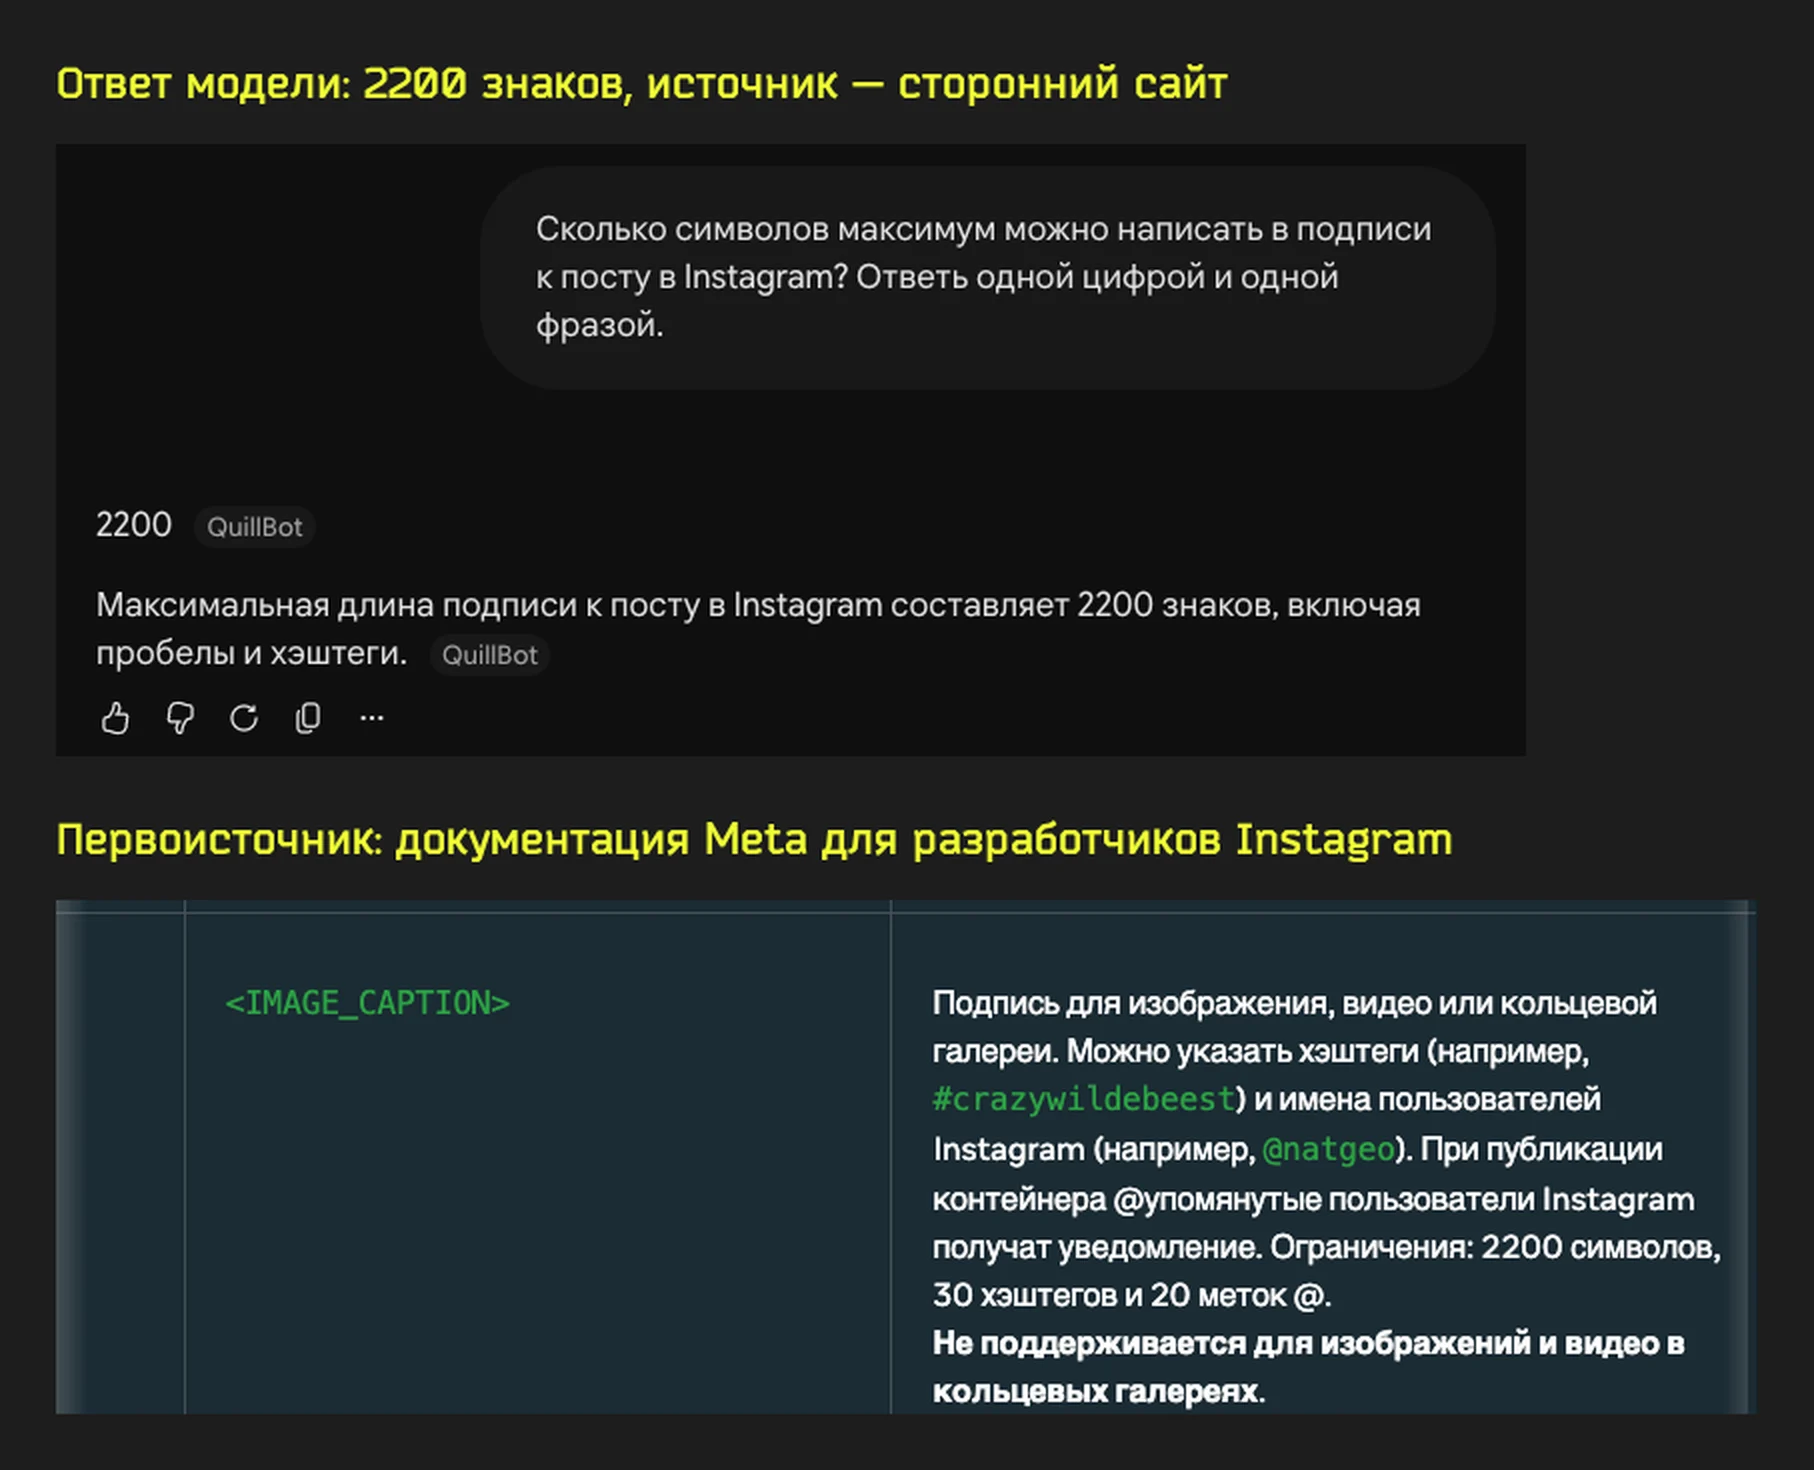
Уверенный ответ, который выдуман: несуществующая цифра, цитата, ссылка, закон, адрес. Возникает потому, что модель продолжает текст правдоподобно, а не сверяет его с реальностью. Тон при этом спокойный и убедительный.
ПримерСпросил, сколько кофеен открылось в Алматы за год, и получил точную цифру с процентом. Источника нет, цифра могла быть придумана. В пост она не идёт, пока не найден первоисточник.
Момент, после которого в данных обучения модели ничего нет. Что случилось позже, она не знает, если у сервиса не включён поиск по интернету.
ПримерТы спрашиваешь про правила рекламы, которые поменялись на прошлой неделе. Без поиска модель ответит по-старому, как будто ничего не менялось.
Склонность модели соглашаться с тобой и подстраиваться под формулировку вопроса. Вопрос с готовым выводом получает подтверждение этого вывода.
Пример«Ведь ролик с лайфхаком лучше, правда?» — модель найдёт доводы за. Спроси нейтрально: «сравни два ролика по плюсам и минусам».
Один и тот же промпт даёт разные ответы, потому что модель выбирает следующий токен с долей случайности. Для идей это плюс, для точных задач минус: повторный запрос не гарантирует верного ответа.
ПримерТри раза попросил названия для набора зёрен — три разных списка, и это хорошо. Три раза спросил дату акции из старого поста — получил разные даты, и тут верить нельзя ни одной.
Чаще всего модель ошибается в точных цифрах, именах, датах, ссылках, цитатах, ценах и узких темах. Реже — когда переписывает твой текст, предлагает варианты или раскладывает материал по полочкам.
Как проверять ответ
- Отметь в ответе всё проверяемое: цифры, даты, имена, ссылки, «по закону», «по исследованиям»
- Найди первоисточник сам: сайт компании, официальная справка сервиса, документ
- Спроси у модели, откуда это, но считай её ответ подсказкой, где искать, а не проверкой
- Нет источника — убери утверждение или подай как своё мнение
- Копируют цифру из ответа в пост, не проверив
- Спрашивают у модели «ты уверена?» и принимают «да» за проверку
- Ведут один бесконечный чат на все задачи
- Ждут, что модель знает последние новости без поиска
- Формулируют вопрос с готовым выводом
- Можешь объяснить, чем модель отличается от поисковика
- Знаешь, что такое токен и контекстное окно
- Умеешь назвать три типа данных, которым нельзя верить без проверки
- Для каждой цифры из ответа находишь источник или убираешь её
Правило урока. Модель пишет правдоподобно, а не проверено. Всё, что можно проверить, проверяет человек.